
In meinem Berufsleben habe ich unzählige Sterbetafeln gelesen, und eine Einsicht daraus hat sich festgesetzt: Man kann sehr genau sagen, wie viele von tausend sechzigjährigen Männern im nächsten Jahr sterben werden, und trotzdem überhaupt nicht, welche es sein werden. Die Vorhersage für die Gruppe ist gut, die Vorhersage für den Einzelnen fast wertlos. Mit dieser Brille habe ich mir angesehen, was die psychologische Forschung über die Vorhersage von Partnerschaften herausgefunden hat. Ich war auf Enttäuschungen gefasst und wurde nicht enttäuscht.
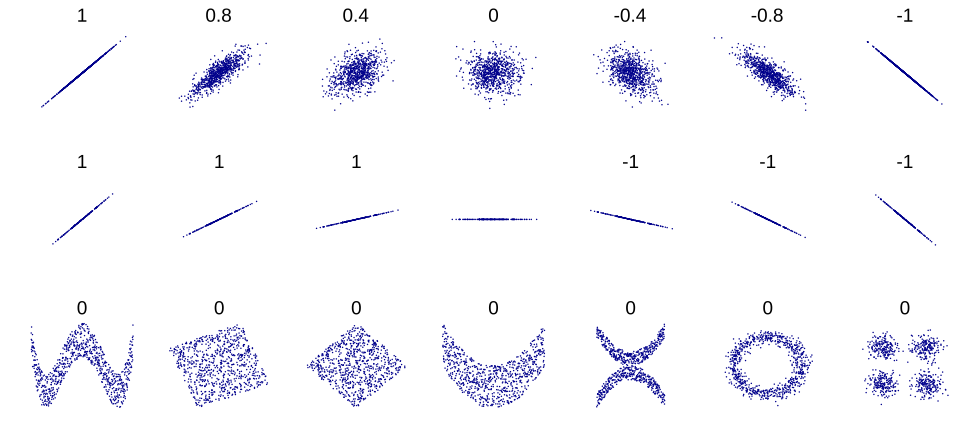
Zuerst ein Wort zum Maß, mit dem in diesen Studien gerechnet wird, weil es sonst leicht zu Missverständnissen kommt. Gemessen wird meist der Anteil der Varianz, der sich durch die untersuchten Merkmale erklären lässt. Wenn eine Beziehungszufriedenheit von Paar zu Paar schwankt, dann fragt man: Welcher Teil dieser Schwankung geht auf das Konto der Merkmale, die man vorher erhoben hat? Ein Korrelationskoeffizient von 0,3, den Psychologen schon als ordentlich ansehen, erklärt nur 0,3 mal 0,3, also 9 Prozent der Varianz. Das habe ich früher unseren Kindern gern auf dem Rand der Zeitung vorgerechnet, weil es so schön zeigt, wie wenig eine „deutliche" Korrelation im Einzelfall bedeutet. Der Rest, hier 91 Prozent, ist alles, was das Modell nicht erfasst.
Die grundsätzliche Kritik kam 2012. Fünf Beziehungsforscher, Eli Finkel, Paul Eastwick, Benjamin Karney, Harry Reis und Susan Sprecher, veröffentlichten in der Zeitschrift Psychological Science in the Public Interest eine lange Übersichtsarbeit über Partnersuche im Internet (Band 13, Heft 1, Seiten 3 bis 66). Einen großen Teil widmeten sie den Matching-Algorithmen, mit denen manche Anbieter werben. Ihr Befund, knapp zusammengefasst: Es gebe kaum Belege dafür, dass diese Verfahren vorhersagen können, ob zwei Menschen zueinander passen. Ihre Begründung finde ich als Rechner überzeugend. Ein Algorithmus kennt nur, was zwei Menschen vor der ersten Begegnung über sich angeben. Die Forschung zeigt aber, dass der Verlauf einer Beziehung stark davon abhängt, wie zwei Menschen miteinander umgehen, wie sie Streit austragen und wie sie mit äußeren Belastungen wie Geldsorgen, Krankheit oder Arbeitslosigkeit fertigwerden. Nichts davon steht in einem Fragebogen, weil es zum Zeitpunkt des Ausfüllens noch gar nicht existiert. Eine Zusammenfassung der Arbeit stellt die Association for Psychological Science frei zur Verfügung.
Fünf Jahre später gingen Samantha Joel, Paul Eastwick und Eli Finkel der Frage mit einem Experiment nach. In zwei Speed-Dating-Studien füllten alleinstehende Teilnehmer vorab mehr als hundert Fragebögen zu Eigenschaften und Vorlieben aus, also genau die Art von Merkmalen, die als relevant für die Partnerwahl gelten. Dann traf jeder Teilnehmer jede Person des anderen Geschlechts zu einem Gespräch von vier Minuten. Anschließend wurde ausgewertet, wie gut sich das gegenseitige Interesse aus den Vorabdaten vorhersagen ließ. Die Autoren verwendeten dafür Random Forests, ein Verfahren des maschinellen Lernens, das gerade dann stark ist, wenn viele Merkmale auf verschlungene Weise zusammenwirken. Das Ergebnis erschien 2017 in Psychological Science (Band 28, Seiten 1478 bis 1489) und hat drei Teile. Wie sehr jemand generell andere begehrt, ließ sich zu 4 bis 18 Prozent vorhersagen. Wie sehr jemand generell von anderen begehrt wird, zu 7 bis 27 Prozent. Der dritte Teil ist der entscheidende: Wie sehr eine bestimmte Person eine bestimmte andere Person begehrt, über diese allgemeinen Neigungen hinaus, ließ sich mit keiner Kombination der Vorabdaten vorhersagen. Genau diese spezifische Passung zwischen zwei Menschen verspricht aber ein Matching-Verfahren.
Man kann einwenden, vier Minuten seien keine Beziehung. Deshalb ist die zweite Arbeit derselben Forschergruppe so wertvoll. Für die Studie, die im August 2020 in den Proceedings of the National Academy of Sciences erschien (Band 117, Heft 32, Seiten 19061 bis 19071), legten 86 Forscher aus 29 Laboren ihre Daten zusammen: 43 Längsschnittstudien mit 11.196 Paaren, die im Schnitt über gut ein Jahr mehrfach befragt worden waren. Wieder kamen Random Forests zum Einsatz, diesmal mit dem Ziel, die Beziehungsqualität vorherzusagen. Die vollständige Arbeit ist frei zugänglich.
Die Befunde lassen sich in wenigen Sätzen sagen. Am besten sagten Angaben über die Beziehung selbst die Zufriedenheit voraus: wie engagiert man den Partner wahrnimmt, wie viel Wertschätzung man empfindet, die sexuelle Zufriedenheit, wie zufrieden man den Partner einschätzt und wie viel Streit es gibt. Diese beziehungsbezogenen Angaben erklärten zu Beginn bis zu 45 Prozent der Varianz, am Ende der jeweiligen Studie noch bis zu 18 Prozent. Persönliche Merkmale wie Lebenszufriedenheit, Neigung zu negativen Gefühlen, Depressivität oder Bindungsangst erklärten 21 und 12 Prozent. Die eigenen Angaben einer Person sagten zwei- bis viermal so viel voraus wie die Angaben ihres Partners. Und wenn man die eigenen Einschätzungen der Beziehung schon kannte, brachten weder die persönlichen Merkmale noch die Angaben des Partners zusätzliche Vorhersagekraft. Ob eine Beziehung im Laufe der Zeit besser oder schlechter wurde, ließ sich aus keiner Kombination der Fragebogendaten nennenswert vorhersagen.
Für die Partnersuche ist das eine unbequeme Nachricht. Die stärksten Vorhersagegrößen beschreiben eine Beziehung, die es schon gibt. Eine Partnerbörse, die zwei Fremde zusammenbringen will, hat davon nichts, sie hat nur die Persönlichkeitsmerkmale beider Seiten. Und gerade die Merkmale der anderen Person trugen in diesen Daten am wenigsten bei. Über die Frage, wie die Vorschläge technisch zustande kommen, habe ich einen eigenen Text geschrieben: Wie Partnerbörsen rechnen.
Bleibt die Ähnlichkeit, auf die viele Verfahren setzen. Hier ist eine ältere Metaanalyse aufschlussreich. R. Matthew Montoya, Robert Horton und Jeffrey Kirchner werteten 2008 im Journal of Social and Personal Relationships 313 Untersuchungen mit 460 Effektgrößen aus (Band 25, Heft 6, Seiten 889 bis 922). Sie unterschieden zwischen tatsächlicher Ähnlichkeit, die man mit Fragebögen bei beiden Personen misst, und wahrgenommener Ähnlichkeit, also dem Eindruck, man sei sich ähnlich. Beide hingen in den Studien mit Anziehung zusammen. Die tatsächliche Ähnlichkeit wirkte aber vor allem dort, wo sich die Menschen gar nicht oder nur kurz begegnet waren. In bestehenden Beziehungen war ihr Effekt nicht mehr signifikant. Die wahrgenommene Ähnlichkeit dagegen blieb in allen Situationen ein Faktor. Etwas zugespitzt: Für das Glück eines Paares scheint wichtiger zu sein, ob man sich ähnlich fühlt, als ob man es auf dem Papier ist.
Meine Frau und ich sind auf dem Papier ziemlich verschieden. Sie liest Romane, ich lese Tabellen. Nach mehr als vier Jahrzehnten würde ich trotzdem sagen, dass wir uns in den wichtigen Dingen ähnlich sind, und ich vermute, sie würde das auch sagen. Ob ein Fragebogen das 1979 herausgefunden hätte, bezweifle ich nach dieser Lektüre stärker als vorher.
Was folgt daraus, ohne es zu übertreiben? Die Studien sagen nicht, dass Persönlichkeit egal ist. Sie sagen, dass die Vorhersage einer bestimmten Paarung aus Vorabdaten bisher nicht gelingt, genau wie der Aktuar nicht weiß, welcher der tausend Sechzigjährigen es trifft. Ein Fragebogen kann grob sortieren und offensichtlich Unpassendes aussortieren, etwa wenn einer unbedingt Kinder will und der andere auf keinen Fall. Mehr sollte man von ihm nicht erwarten. Wer die Auswahl dann dem Zufall und der eigenen Erfahrung überlassen muss, kann sich wenigstens an einer mathematischen Faustregel orientieren, der 37-Prozent-Regel. Die vollständigen Angaben zu den hier besprochenen Arbeiten stehen unter Quellen.